来源:中国产业新闻网 2026-11-10 17:48:26
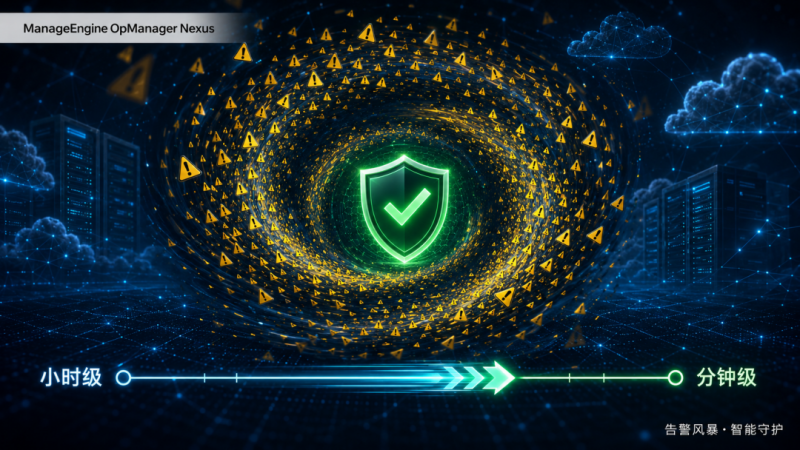
Summary:一台云主机 IOPS 突增,2000 多条告警跟着响。去年双十一要 40 分钟才查出来,今年618只需 5 分钟。
双11倒计时 1 天。
这句话对多数人是促销提醒,对电商运维是另一件事——又到了那个告警量翻四倍、值班表排满 24 小时、谁都不敢关手机的月份。
去年双11,某头部电商品牌的运维团队在启动两小时后,看到告警从日均 800 条涨到 3700 余条。三个监控平台同时开始响。
那天他们花了近 40 分钟,才确认问题出在一台云主机的 IOPS 上。
今年618,同一个支付链路又出了问题。这一次,5 分钟。
双11最值的,从来不是折扣,而是那一秒的卡顿。
01.去年那 40 分钟,输的不是人手
故障的起点很小——一次支付数据库的轻微抖动。它沿着调用链滚下去,最终带出 2000 多条级联告警:应用超时、容器重启、连接池打满,各维度的红点一起亮。
真正的问题不在告警多,在于没有人能一次看完。
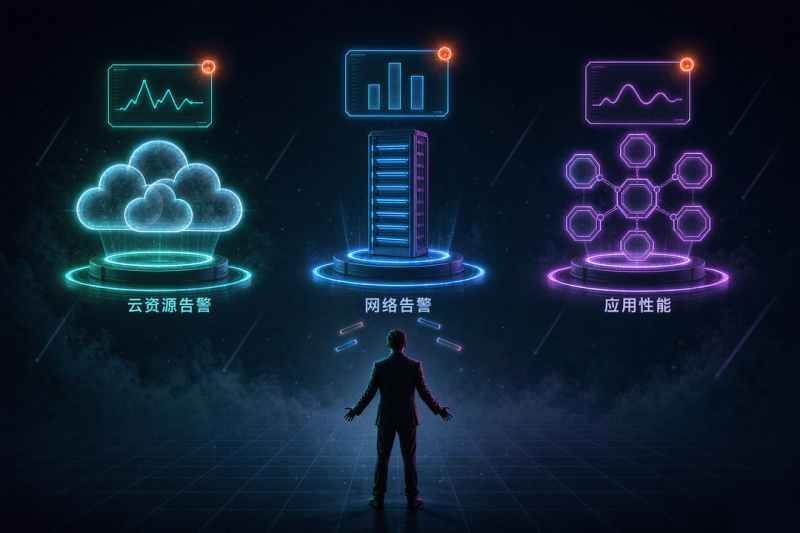
该品牌的 IT 架构横跨公有云、本地 IDC 与 CDN 节点。网络告警在一个平台,云资源告警在另一个,应用性能数据在第三个。
三个监控系统各自为政。故障发生时,工程师要做的是反复切换界面、手工把时间线拼起来。
这套动作在平峰期还应付得来。大促不行。大促里每延迟一分钟,损失的计量单位是百万。
更危险的是告警疲劳。值班工程师连续几小时面对高密度、低质量的告警,敏感度会系统性钝化。那晚有两条高危告警差点被下意识划掉——不是能力问题,是人的带宽到了上限。
所以那 40 分钟,不是反应慢,是结构性错配:告警量指数级上涨,研判还是靠人一条条看。告警涨得越快,效率掉得越狠。
02.半年后618,同样是支付链路,5 分钟
去年双11之后,这家品牌把监控体系换成了 OpManager Nexus——ManageEngine 卓豪的全栈智能运维平台,使用On-Prem版直接部署在他们自己的 IDC 里,监控数据不出企业边界。
今年618,同一个支付链路再次抖动。流程完全倒过来了。
第一步不是“看告警”,是平台先看完了。
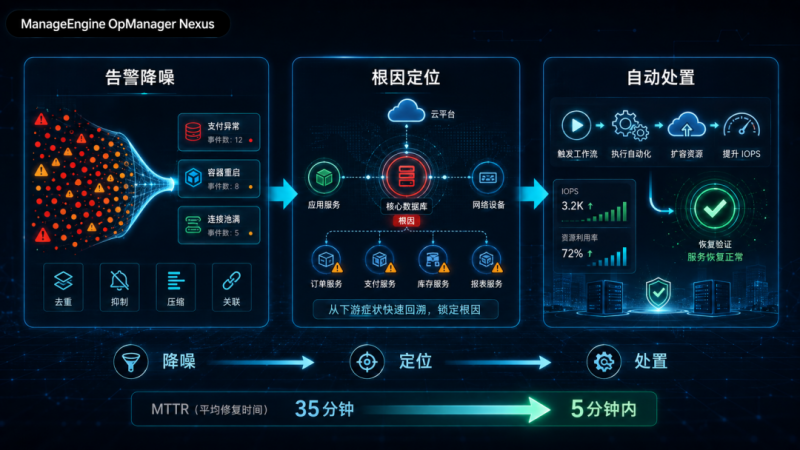
AI小助手 Zia 对涌入的原始告警实时做去重、压缩与抑制,叠加 AI 相关性分析,把同源告警聚合成一个带上下文的高级事件。数千条原始告警收敛成十几个事件,按业务服务维度排好序。
值班人员打开页面看到的不是洪水,是一张清单,第一行写着“支付链路异常”。
第二步是定位。OpManager Nexus基于全栈资源依赖拓扑,把告警与性能指标、配置变更、日志时序放在一起反向推演,从下游大片服务超时里倒推上游真正的根因节点——仍是那台云主机的 IOPS 突增。
从告警进来到锁定根因,分钟级。
第三步是处置。对“IOPS 过高导致响应变慢”这类处置路径明确的已知故障,IT团队在平台上通过Zia自定义脚本与拖拽式自动化工作流功能,不用编写一行代码即对几个典型场景预置了触发式自愈工作流。
告警触发、故障验证、自动弹性扩容、临时抬升 IOPS 上限、验证恢复效果,全程不需要人按任何一个键。
去年要 40 分钟才走完的第一步,这次三分钟内完成。整条链路的 MTTR,从 35 分钟压到 5 分钟以内。
03.三个数字,把“快了多少”说清楚
三组数字,正好对应上面那条链路的三步。
2000+ → 十几个
单次故障的级联告警 → 可处置事件
工程师眼前的东西,从“看不完”变成“看得完”
近 40 分钟 → 分钟级
从“告警响”到“知道是哪台机器”
这是 MTTR 里最长的一段,也是压缩空间最大的一段
35 分钟 → 5 分钟以内
MTTR,降幅 85.7%(30/35)
同样的人、同样的链路、同样的大促流量
有一点要说清:人没有变少,值班表还是那几个人。变的是他们不再做检索题,只做判断题。
04.对电商与零售
这套东西到底省下了什么
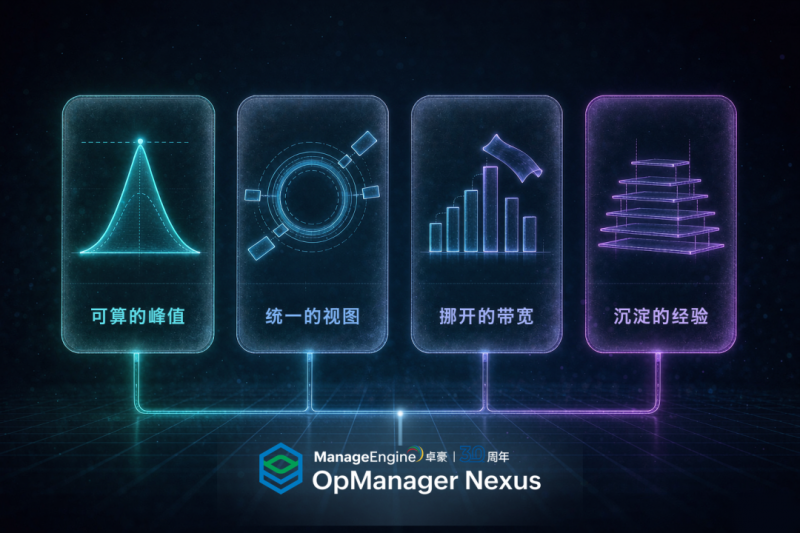
撇开个案细节,OpManager Nexus 对电商与零售行业真正有用的,是四件事。
一、把“峰值”变成可计算的东西。大促的难点是流量不可预测。自适应阈值每小时基于历史数据自动重算,正常波动不再产生告警。
性能趋势预测能算出 CPU、内存、带宽、磁盘的耗尽时间,扩容预案从凭经验估变成照表执行。
临时扩出来的云主机和容器,自动化发现加模板批量下发,几分钟内纳入监控——不会再有“新机器没被监控”这种事。
二、让混合架构不再等于告警孤岛。电商几乎没有纯云或纯 IDC 的架构。全栈可观测性把网络、服务器、应用、云资源汇到同一个视图,依赖关系是平台的底层数据结构,不是人脑里的记忆。
跨平台拼时间线这个动作,被取消了。
三、把人的带宽从瓶颈位上挪开。拖拽式无代码工作流内置 70 多种操作,标准故障交给流程跑。没有专职 SRE 的中小团队也能配起来——这是零售行业里更常见的情况。
四、让每次大促都留下东西。报表与趋势分析能复盘告警分布与处置效果,把新出现的故障模式沉淀成阈值策略和自动化工作流。第一年靠临时保障,第三年就成了常态能力。
它改变的不是告警的数量,是告警量与响应速度之间那条耦合关系。
05.距今年双11还有 1 天
今年双11的流量曲线大概率比去年更陡。如果团队现在还在用“三个平台加一个通宵”的方式准备,能做的事其实只剩三件。
第一件,把告警收敛跑一遍。先看现有系统有没有去重与抑制规则,能不能按业务服务重新分组。不用等平台上线。
第二件,把核心链路的依赖图画出来。支付、下单、库存三条链路,各自的上游资源是什么。这张图不出现在白纸上,就一定出现在凌晨的排查里。
第三件,挑一条处置路径明确的故障做成自动化。不用多,一条就够。它会告诉你自动化到底能省多少。
三件事做完,你已经比去年的自己快一步。明年这个时候,是继续复盘那 40 分钟,还是开始写那 5 分钟,取决于这 1 天。
OpManager Nexus 提供本地部署(On-Prem)与云服务(Cloud)两种形态。
本地部署版适配国产化环境,满足合规性要求,监控数据始终留在企业自己的安全边界内;纯云上的团队可以直接用云服务版。
【广告】本内容为广告,相关素材由广告主提供,广告主对本广告内容的真实性负责。本网发布目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责,广告内容仅供读者参考。
九赴进博,再续十年之诺:拜耳以“黑科技”和十余项合作签约交出进博新答卷