来源:中国产业新闻网 2026-09-28 11:46:42
—LLM4MIP:求解器+自主思考的AI
电网的机组启停、高铁的运行时刻、大模型训练与推理中的GPU资源分配,看似不同的决策任务,背后都可能是一道混合整数规划问题(Mixed Integer Programming,MIP)。求解这类问题,不仅要找到一个好方案,还要证明“没有更好的方案”;而一些极难实例,长期未能跨过这道门槛。
求解MIP通常依靠Gurobi、COPT、CPLEX等专业求解器,通过分支定界、割平面等算法搜索方案并证明最优性。但一些困难问题仍需要研究者分析结构、设计针对性方法。这也引出一个问题:大模型能否参与这一过程,帮助求解器取得突破?
近期,斯坦福大学、上海财经大学、上海数学与交叉学科研究院(SIMIS)、杉数科技COPT团队共同启动了LLM4MIP项目:(https://llm4mip.github.io/)。
LLM4MIP项目从217个MIPLIB(v36)“open”实例中随机选取了 132 个例子,这些例子均尚未记录最优性或不可行性。他们让大模型(GPT5.6-sol)阅读问题信息、寻找问题背景、分析模型结构,并按需要调用COPT、Gurobi 等优化求解器。重点是利用大模型强大的发散思维和推理能力,寻找问题本身可利用的规律,再据此设计求解方法。大模型提出思路,求解器承担计算,最终结果通过外部检查确认,并进一步从中总结可能的skill,应用于新的问题求解。
结果是非常振奋人心的。LLM4MIP 在 132 个开放实例上中有77个取得了可验证的求解进展:32 个完成了求解最优性判定、2 个完成了不可行性证明、29 个实现了可行解提高,以及 66 个优于 COPT 10 小时基线的全局界。这些成果展示了大模型通过结构分析和针对性方法推进困难优化问题求解的潜力。部分结果已经在最新的MIPLIB求解网站上验证通过并公开出来:https://miplib.zib.de/CHANGELOG.html#2026。
图 1|MIPLIB 收录来自不同应用领域的优化问题,部分实例仍标记为 open。
132 个难问题上的可验证改进
衡量一个优化问题是否进展,主要体现在三个方面:证明最优性、找到更好的可行解,以及强化全局下界。可行解与全局下界之间的差距越小,离最优解的距离就越接近。
确定最优答案:32 个实例达到最优判定,另有 2 个证明不可行。
找到更好的可行解:相较于 MIPLIB v36,25 个实例改善已有可行解,4 个此前没有已知可行解的实例首次找到严格可行解,共更新 29 个实例的记录。
强化全局界:66 个实例的全局下界优于 COPT 运行 10 小时的结果,进一步缩小与最优值的差距。
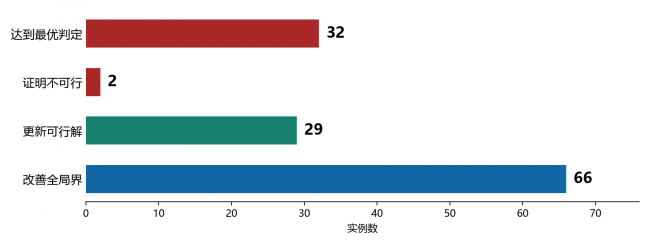
图 2|132 个实例的主要结果。32 个最优判定。29个可行解改善。66全局下界改善。
从成果的覆盖范围来看,132 个实例中共有 77 个至少一项界得到改善:11 个仅改善可行解,48 个仅改善全局界,18 个同时改善两端。另一方面,32 个实例达到最优判定,2 个证明不可行。“
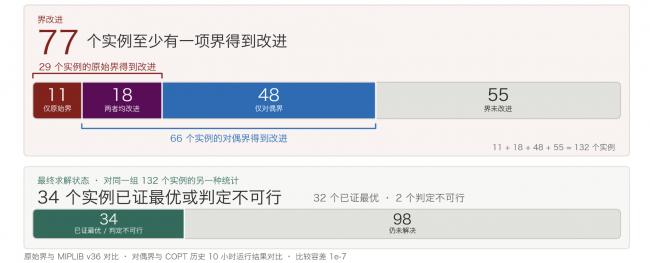
图 3|132 个实例中77个求解得到了实质性提高
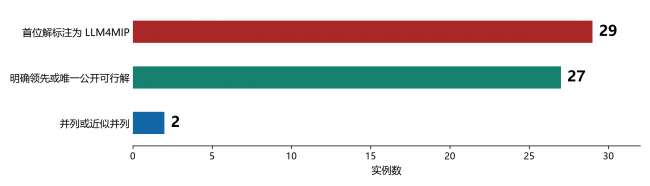
MIPLIB v37 榜单中,29 个问题首位解标注为 LLM4MIP
在 2026 年 9 月 24 日发布的 MIPLIB v37 榜单中,有 29 个问题的首位解标注为 LLM4MIP,全部达到当前官网最好目标值。其中,27 个明确领先于其他公开解或为唯一公开可行解,另有 2 个并列或近似并列。这次更新将项目中的可行解成果呈现在公共基准库中。完整的 29 个实例页面截图见网站。
大模型如何识别并利用问题的结构规律
一个直观案例来自图上的割打包问题:每个“割”把节点分成两组,希望选出尽可能多、又不共享边的割。LLM 分析图结构后,识别出可利用的规律:对于节点两两相连的“团”,任意两个穿过它的割都会共享边,因此不能同时选择。图中的红边就展示了这样的冲突。
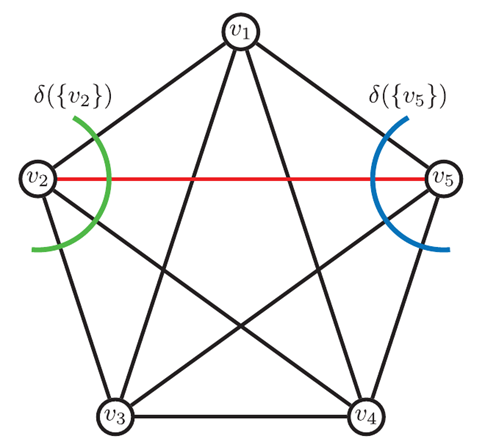
图 3|两个割共享红边,因而不能同时选入。LLM 识别这类结构规律,将其写成有效不等式以强化模型。
利用这一结构构造有效不等式,强化全局界,再结合 SAT/LRAT 可验证证明闭合剩余间隙,两个实例最终达到最优:
全局下界提升:
graph40-40-1rand −68.96 → −9 Optimal
graph40-80-1rand −495.45 → −7 Optimal
这展示了结构识别的实际价值:从图中发现规律,将其转化为有效约束,并结合证明把界的改善推进到最优性判定。类似的进展也出现在其他实例中:allcolor58 通过目标值 42 的可行解和同为 42 的下界完成最优判定;nj1 则在MIPLIB没有公开可行解的情况下,得到了经过验证的可行解。
从求解一个问题到积累可复用的 skill
如何将一个问题上的成功经验用于其他问题? 他们从最初112个实例的研究中提炼共性的结构规律,将有效方法整理为两类可复用的技能:primal-skill 和 dual-skill。
Primal-skill 关注怎样构造、修复和改进可行解。例如,先保留已有方案中较好的部分,再集中调整造成冲突的少量变量。Dual-skill 则关注怎样建立更强的松弛、发现有效不等式,并验证全局界。两类skill分别指导大模型从“找更好的方案”和“证明不能更好”两个角度推进研究。
团队在同一组 20 个实例上测试了两类skill,每类skill处理实例的时间上限均为 150 分钟。相比未使用skill的大模型,10 个实例获得了更好的可行解;17 个实例的全局下界得到改善。
将两类skill得到的最佳可行解与全局界结合后,20 个实例中有 18 个最优性差距小于普通大模型,16 个小于求解器基线。这表明,将成功经验整理为可复用的skill,有助于大模型更有效地求解新问题。
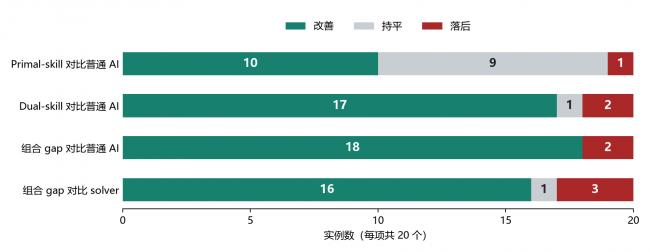
图 4|20 个实例上的技能比较。solver 基线取记录中 Gurobi 与 COPT 的最佳有效界;组合 gap 使用两类skill运行后的最佳有效 primal 与 dual。
大模型能替代求解器吗?
MIP 上的进展,是否意味着大模型已经能够替代成熟求解器?团队选取 Mittelmann 榜单的 40 个线性规划实例,比较LLM 自行寻优、LLM调用求解器寻优,以及求解器直接求解三种方式。
三种寻优方式的区别:受限LLM不能直接将完整模型或其等价形式交给求解器,多数实例LLM会自行编写内点法或 PDHG 算法求解。允许调用求解器时,LLM会自行选择算法与参数,再由求解器处理完整模型。纯求解器COPT则采用默认参数求解。
| 工作流 | 求解结果 | 用时* |
| 受限LLM | 16/40数值最优 | 60+分钟 |
| LLM+求解器 | 40/40 数值最优 | 约 6 分钟 |
| 求解器COPT | 40/40数值最优 | 8.17 秒 |
表 1|40 个 LP 实例的结果与用时。60+分钟为LLM整体平均求解时间,约 6 分钟采用的大模型 + 求解器整体平均用时估算;8.17 秒为求解器COPT时间几何均值。
从时间上看,受限的LLM整体用时超过60分钟,LLM+求解器整体求解用时估算约为每个实例6 分钟,而求解器COPT完成求解的平均时间为 8.17 秒。这一对比提醒我们:大模型参与分析和选择方法,也会带来额外时间成本。
所以,目前来看,大模型在个别线性规划实例上有帮助,但整体效果仍不理想,尚不能可靠替代专业求解器。它更有潜力承担的角色,是发现结构、提出方法,再与成熟算法协同工作。
LLM4MIP工作由上海财经大学博士生黄奕程、斯坦福大学博士生高文智,以及斯坦福大学 Madeleine Udell教授、叶荫宇教授(SIMIS)和杉数科技COPT团队的葛冬冬教授共同完成。
欢迎访问 LLM4MIP 项目网站(https://llm4mip.github.io/),查看完整结果、实例分析与代码,下载 primal-skill 和 dual-skill,探索大模型与数学优化结合的更多可能。
【广告】本内容为广告,相关素材由广告主提供,广告主对本广告内容的真实性负责。本网发布目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责,广告内容仅供读者参考。